Esse artigo fala sobre um tema espinhoso: pesquisa quantitativa. Você um dia vai ouvir falar da famosa “significância estatística”, p-valor, tamanho do efeito. Com esse artigo você vai ter condições de não ficar boiando e mais, vai poder até questionar um tabu no mundo da estatística.
O cenário comum
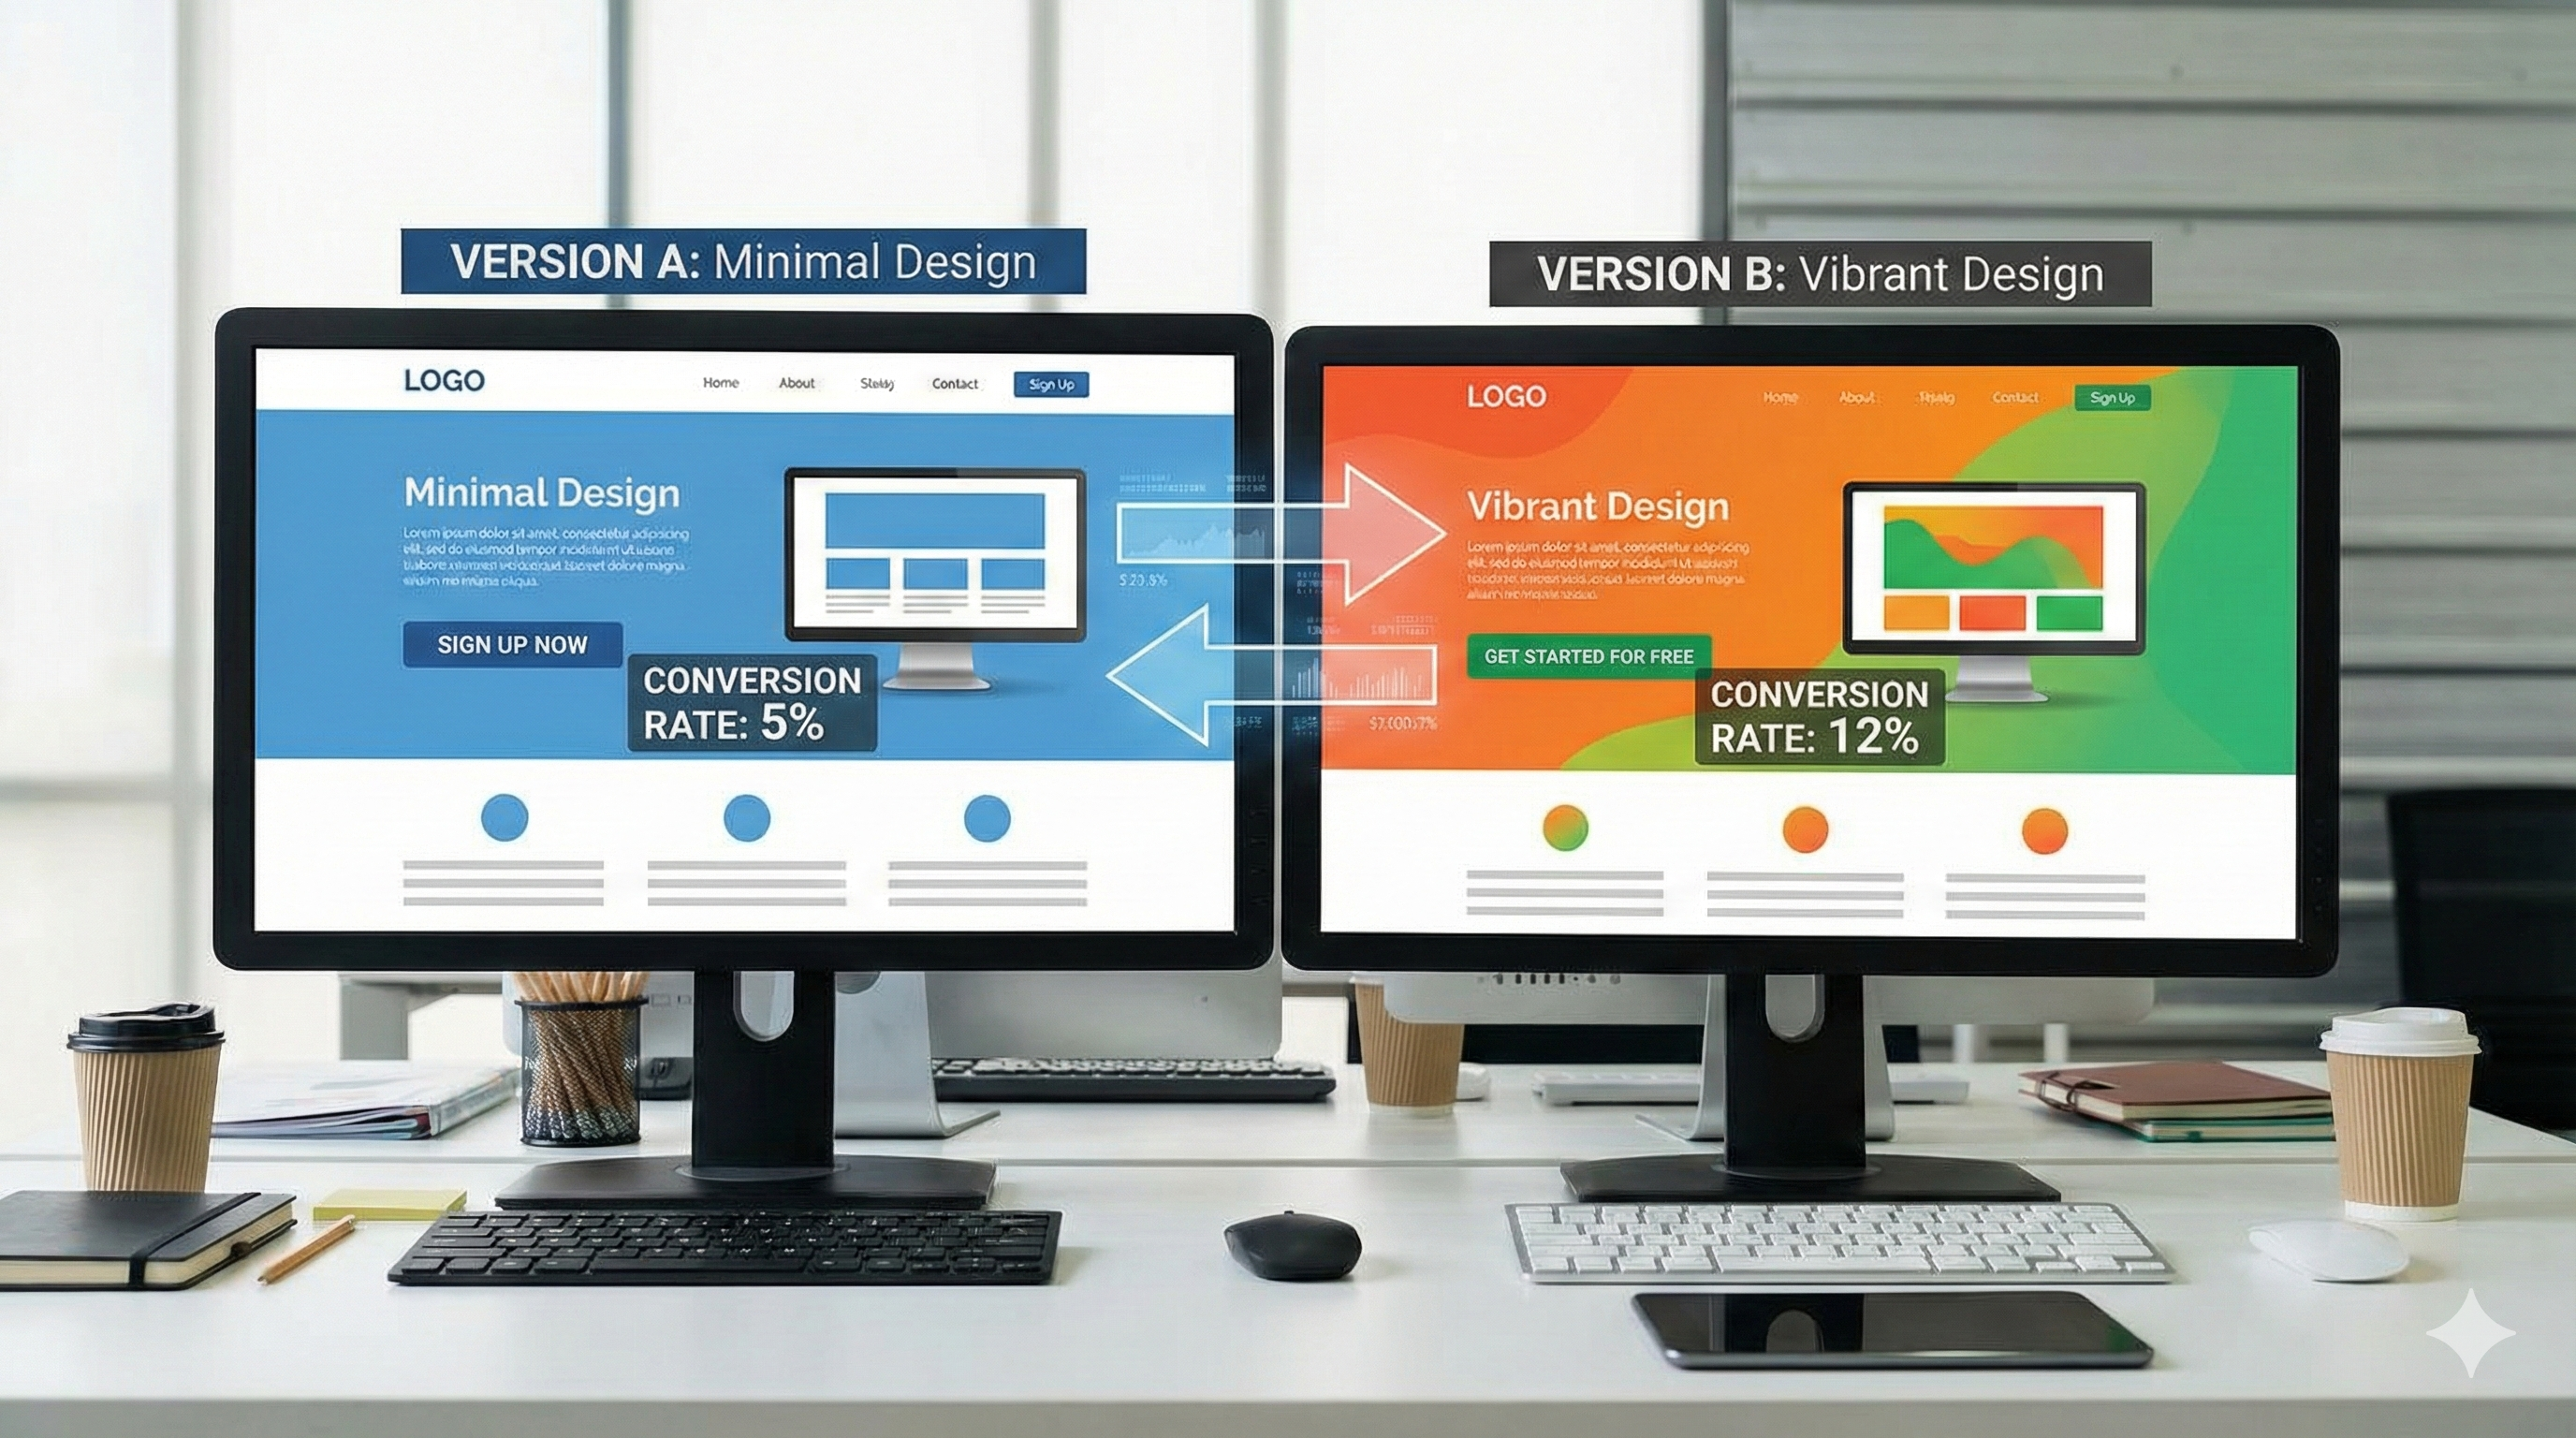
Você (ou seu time) fez um teste A/B e testou duas versões de um botão de checkout. A versão A teve taxa de conversão de 12,5% e a versão B teve 10%. A ferramenta de testes diz que a diferença é estatisticamente significante com p < 0,05.
Você apresenta os resultados: ‘A versão A funciona, a versão B não. Devemos implementar a versão A.’
Parece razoável, certo? Mas há um problema nessa lógica que pode levar a decisões erradas.
O que o teste realmente disse
Quando um teste A/B diz que algo é ‘estatisticamente significante’, ele está dizendo: ‘é improvável que essa diferença tenha acontecido por puro acaso se as duas versões fossem idênticas.’
Quando diz que algo ‘não é significante’, está dizendo: ‘essa diferença poderia facilmente ser só sorte do acaso.’
Mas aqui está o pulo do gato:
Só porque um resultado cruzou a linha do ‘significante’ e outro não, não significa que eles sejam diferentes entre si.
Um exemplo prático de UX
Imagine que sua empresa testou dois redesenhos diferentes de uma página de produto:
-
Redesenho A: aumentou as compras em 8% (p = 0,02, significante)
-
Redesenho B: aumentou as compras em 5% (p = 0,08, não significante)
A conclusão óbvia seria: ‘O redesenho A funciona, o B não. Vamos com o A.’
Mas espera. A diferença entre 8% e 5% é só 3 pontos percentuais. Essa diferença de 3% entre os redesenhos pode facilmente ser variação aleatória. Os dois redesenhos podem na verdade ter o mesmo efeito real (digamos, uns 6,5%), e a diferença que você viu foi só sorte.
Se você tivesse testado eles com mais usuários, talvez ambos mostrassem 6,5% de aumento. Ou talvez o B mostrasse 9% e o A 5%. Você não sabe.
Por que isso importa para decisões de negócio
Imagine agora que:
-
O redesenho A é simples e custa R$ 10.000 para implementar
-
O redesenho B é mais complexo mas tem potencial de fidelização, e custa R$ 50.000
Se você decidir baseado apenas em ‘A é significante, B não é’, vai escolher A. Mas se os dois redesenhos na verdade têm efeitos similares, você está deixando de considerar outros fatores importantes como custo, manutenção, experiência do usuário a longo prazo.
Pior ainda: você pode reportar ao time executivo que ‘testamos e o redesenho B não funciona’, quando na verdade você só não teve certeza estatística suficiente.
Outro cenário comum: múltiplas variações
Você testou 5 cores diferentes para um botão de CTA:
-
Verde: +12% de cliques (p = 0,01, muito significante)
-
Azul: +11% de cliques (p = 0,03, significante)
-
Laranja: +10% de cliques (p = 0,06, não significante)
-
Vermelho: +9% de cliques (p = 0,09, não significante)
-
Roxo: +8% de cliques (p = 0,15, não significante)
É tentador concluir: ‘Verde e azul funcionam, as outras não.’ Mas olhe para os números reais. Todos aumentaram os cliques entre 8% e 12%. A diferença entre eles é pequena.
O que mudou foi principalmente a
certeza estatística, não necessariamente o efeito real. Com mais usuários no teste, talvez todas mostrassem efeito significante. Ou talvez nenhuma mostrasse.
A decisão de qual cor usar deveria considerar outros fatores: identidade da marca, acessibilidade, contraste com o fundo, consistência com o design system. Não apenas ‘qual cruzou a linha mágica do p < 0,05’.
A linha mágica do 0,05 não é tão mágica assim
Você já deve ter percebido que tudo gira em torno desse número: p < 0,05. Mas de onde ele veio? Por que 5% e não 6% ou 3%?
A resposta é: é completamente arbitrário. Foi popularizado há quase 100 anos e virou padrão por convenção, não por alguma lei da natureza.
Na verdade, dependendo do contexto, você pode (e talvez deveria) usar valores diferentes:
Quando usar um valor mais rigoroso (p < 0,01 ou até p < 0,001):
-
Quando o custo de um erro é alto. Por exemplo, se você está testando uma mudança que vai custar R$ 500.000 para implementar em todo o app, você quer ter certeza muito alta antes de aprovar.
-
Quando você está fazendo muitos testes ao mesmo tempo. Se você testar 20 variações diferentes, estatisticamente uma delas vai aparecer como ‘significante’ por puro acaso, mesmo que nenhuma tenha efeito real. Ser mais rigoroso ajuda a compensar isso.
Quando usar um valor mais flexível (p < 0,10 ou até p < 0,15):
-
Quando você está em fase exploratória. Se você está testando uma ideia nova só para ver se vale a pena investir mais, um p < 0,10 pode ser evidência suficiente de que ‘tem algo aqui, vamos investigar melhor’.
-
Quando a amostra é necessariamente pequena. Se você está testando um produto B2B que tem só 500 clientes no total, nunca vai conseguir p < 0,05 em muitos testes. Um p < 0,15 com contexto qualitativo forte pode ser suficiente.
-
Quando o custo de implementar é baixo e reversível. Se a mudança é só trocar a cor de um texto e você pode reverter em 5 minutos, um p < 0,10 já pode justificar tentar.
-
Quando perder uma oportunidade é pior que testar algo que não funciona. Em mercados muito competitivos, esperar certeza absoluta pode significar perder para concorrentes mais ágeis.
O importante é ser transparente:
Se você decidir usar p < 0,10, não esconda isso. Diga: ‘Este resultado tem p = 0,08, que é acima do padrão de 0,05, mas dado o baixo custo de implementação e o potencial de ganho, vale a pena testar.’
O problema não é usar critérios diferentes. O problema é tratar 0,05 como uma linha mágica que separa a verdade absoluta da completa incerteza, quando na real é só um número que alguém escolheu há muito tempo atrás.
O que fazer na prática
1. Olhe para os números reais, não só para o selo de ‘aprovado’
Em vez de só olhar se deu ‘significante’ ou não, pergunte: qual foi o aumento real? A versão A aumentou conversões em 8% e a B em 5%? Essa diferença de 3% importa para o negócio? Vale a pena escolher A por causa disso?
2. Compare diretamente quando for relevante
Se você quer saber se A é melhor que B, teste isso diretamente. Algumas ferramentas de teste A/B permitem comparar duas variações entre si, não apenas cada uma contra o controle. Se você só tem os números, calcule se a diferença entre A e B é significante (ou peça ajuda de um analista).
3. Considere o tamanho do efeito junto com a significância
Um teste pode mostrar que uma mudança no botão aumentou cliques em 0,5% de forma estatisticamente significante. Mas 0,5% pode não valer o esforço de implementação. Por outro lado, um aumento de 15% que não deu significante (porque o teste foi pequeno) pode valer a pena investigar mais.
4. Comunique com nuance
-
Em vez de: ‘A funciona, B não funciona.’
-
Diga: ‘A mostrou aumento de 8% com alta confiança estatística. B mostrou aumento de 5% mas com menor confiança. A diferença entre eles é pequena e pode ser variação aleatória. Ambos parecem melhores que a versão atual.’
5. Lembre que significância estatística ≠ significância prática
Com uma amostra enorme, você pode detectar diferenças minúsculas como estatisticamente significantes. Mas uma diferença de 0,1% na conversão pode não importar para o negócio. Pergunte sempre:
esse tamanho de efeito faz diferença real para os usuários e para a empresa?
Um checklist rápido para apresentar resultados
Antes de apresentar resultados de um teste, pergunte-se:
-
Estou reportando o tamanho real do efeito (8% de aumento) ou só se foi significante?
-
Se estou comparando variações, testei a diferença entre elas ou só olhei se cada uma foi significante?
-
Esse tamanho de efeito importa para o negócio (receita, custos, tempo de implementação)?
-
Estou deixando claro o nível de incerteza nos resultados?
-
Estou considerando outros fatores além da estatística (UX qualitativa, acessibilidade, manutenção, marca)?
Exemplo de boa comunicação de resultados
Ruim:
‘Testamos 3 versões. A versão A foi estatisticamente significante, as outras não. Recomendo implementar A.’
Bom:
‘Testamos 3 versões do formulário de cadastro. A versão A (formulário em uma página) aumentou conclusões em 15%. A versão B (formulário em etapas) aumentou em 12%. A versão C (com validação inline) aumentou em 18%, mas com menos certeza estatística devido ao tamanho da amostra.’
‘Todas as três versões parecem melhores que a atual. A diferença entre elas é relativamente pequena (3-6 pontos percentuais) e pode ser parcialmente variação aleatória.’
‘Recomendo considerar também: a versão C tem melhor feedback qualitativo dos usuários. A versão A é mais fácil de implementar. A versão B é melhor para mobile. Dado que os resultados quantitativos são similares, sugiro decidir com base nesses outros fatores.’
Conclusão
Testes A/B e significância estatística são ferramentas poderosas, mas não são mágica. Só porque um resultado cruzou a linha do p < 0,05 e outro não, não significa automaticamente que você deve escolher o primeiro.
Olhe para os números reais. Considere a magnitude dos efeitos. Compare diretamente quando relevante. E lembre que a decisão final deve integrar dados quantitativos com outros fatores importantes para a experiência do usuário e o negócio.
No fim das contas, você está tomando decisões sobre produtos reais que afetam pessoas reais. Um ‘p < 0,05’ é só uma das muitas informações que devem guiar essas decisões.